Microsoft Word – глибоке навчання проти традиційних моделей_Абдель Хай_Заключна частина. Частина 2
Jan 03, 2024
Для підготовки даних для моделей машинного навчання було виконано наступні методи попередньої обробки даних.
Дані та пам'ять тісно пов'язані. У сучасному суспільстві ми щодня отримуємо велику кількість інформації та даних, включаючи текст, зображення, відео тощо. Для того, щоб ефективно обробити й упорядкувати ці дані, від нас потрібна міцна пам’ять.
З одного боку, дані можуть забезпечити нам підтримку пам’яті. Наприклад, коли ми засвоюємо нові знання, ми можемо швидше й краще зрозуміти й засвоїти знання, запам’ятовуючи відповідні дані та факти. Такий метод навчання може допомогти нам розвинути міцну пам’ять і зберегти здатність контролювати знання протягом тривалого часу.
З іншого боку, дані також можуть допомогти нам тренувати та покращувати пам’ять. За допомогою різних методів тренування пам’яті ми можемо гнучко використовувати дані для тренування пам’яті, певною мірою покращити нашу здатність до пам’яті та, таким чином, краще адаптуватися до розвитку суспільства та потреб роботи та життя.
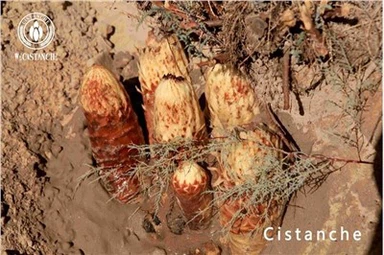
Можна побачити, що зв’язок між даними та пам’яттю дуже тісний і важливий. Лише шляхом активної та ефективної обробки та використання даних ми можемо краще використовувати можливості пам’яті та досягати кращих результатів. Тому ми повинні активно розглядати взаємозв’язок між даними та пам’яттю, проводити відповідні тренінги та застосовувати програми та постійно вдосконалювати свої здібності. Видно, що нам потрібно покращити пам’ять, і Cistanche deserticola може значно покращити пам’ять, оскільки Cistanche deserticola також може регулювати баланс нейромедіаторів, наприклад підвищувати рівень ацетилхоліну та факторів росту. Ці речовини дуже важливі для пам'яті та навчання. Крім того, м’ясо також може покращити кровообіг і сприяти доставці кисню, що може гарантувати, що мозок отримує достатню кількість поживних речовин і енергії, тим самим покращуючи життєздатність і витривалість мозку.

Клацніть «Знай, як покращити роботу мозку».
Категориальні характеристики були одним гарячим кодуванням; неперервні та дискретні характеристики були нормалізовані за допомогою методів мінімально-максимальної нормалізації32, визначених як:

У кожній зустрічі була різна кількість записів для кожної з наступних функцій. Таким чином, замість цього були обчислені наступні статистичні значення. Для діастолічного та систолічного артеріального тиску ми розрахували мінімальне, максимальне та середнє значення.
Для ІМТ використовували мінімум, максимум, середнє значення та коефіцієнт дисперсії. Ці статистичні значення були нормалізовані та використані як характеристики. Крім того, кількість ознак відрізнялася під час зустрічей через різну кількість лабораторних досліджень, діагнозів і процедур. Зустріч може мати кілька діагнозів та/або кодів процедур або жодних.
Щоб виправити це та уніфікувати розмірність векторів ознак, були використані наступні методи представлення даних для покращення вивчення моделей. Для кодів діагностики та процедур ми використовували подання одноразового кодування, де кожне значення встановлювалося як 0 або 1, що вказує, чи існував код діагностики/процедури чи ні для кожної зустрічі. Ми дещо змінили цю техніку представлення даних для лабораторних тестів, оскільки кожен тест мав пов’язаний результат.
Таким чином, ми замінили 1, який вказував на існування коду, на лабораторний результат. Лабораторні результати були нормалізовані за допомогою рівняння 1. Оскільки результати були в різних одиницях вимірювання, під час нормалізації лабораторних результатів ми розглядали мінімум і максимум для кожного коду лабораторії окремо. Ця техніка створила багатовимірний розріджений масив завдяки багатьом унікальним кодам.
Потім ми використали алгоритм декомпозиції сингулярного значення (SVD), щоб дізнатися про вбудовування та зменшену розмірність. SVD використовувався, оскільки він не передбачає використання квадратної матриці як вхідних даних і кращий для розріджених даних.33 Лабораторні тести були скорочені до 50 компонентів, процедура коди були скорочені до 45 компонентів, а коди діагностики – до 25 компонентів.
Було досліджено різні компоненти та спостережено суму співвідношення дисперсій, щоб визначити оптимальну кількість компонентів для зменшення розмірності. Усі функції були об’єднані у вектор ознак для кожної зустрічі. SVD застосовувався для кожного зіткнення окремо, щоб зменшити та уніфікувати розміри; розмір зустрічей було зменшено до 50 характеристик на зустріч.

Потім ми об’єднали всі зустрічі для даного пацієнта у вектор ознак, упорядкований послідовно за датою надходження. Розподіл за класами становив 27 511 пацієнтів без повторної госпіталізації (негативний клас) і 9 130 пацієнтів, які були повторно госпіталізовані (позитивний клас).
Експериментальні підходи
Ми провели масштабні експерименти з використанням даних EHR для досягнення таких цілей:
- Спрогнозуйте, чи будуть пацієнти з діабетом повторно госпіталізовані протягом 30 днів
- Порівняйте продуктивність використаних методів DL з кількома традиційними моделями
- Проаналізуйте, скільки попередніх зустрічей (тобто історичних даних) протягом 2 років є оптимальним для прогнозування реадмісії
- Оцініть вплив включення всіх лабораторних тестів у дані порівняно з вивченням підмножини тестів, вибраних експертом у галузі
У цьому дослідженні DL-моделі приймають як вхідні дані 3-3-мірний тензор � x � x � для представлення f характеристик для кожного з e зустрічей для p пацієнтів. Навпаки, у традиційних моделях дані зазвичай представлені у вигляді 2-розмірної матриці з усіма ознаками всіх випадків, що відповідають одному пацієнту, з’єднаними в довгий вектор ознак.
Розмірність кожного зіткнення було зменшено та уніфіковано до 50 ознак, отже, у глибокій моделі � має розмір 50. У традиційній моделі вектор ознак складається з усіх зіткнень і тому має розмір � x 50.
Пацієнти мають різну кількість зустрічей, що призводить до неоднорідних розмірів; отже, вектори ознак були доповнені 0 для досягнення уніфікованої форми. Представлення даних, що використовуються як вхідні для DL і традиційних моделей, показано на лівій і правій панелях рисунка 1 відповідно.
Щоб змоделювати неоднорідні послідовні дані, ми розробили 2 варіанти моделей DL і порівняли обидва з кількома традиційними моделями, які використовуються як базові. Моделі DL, які використовувалися в нашому дослідженні, були: 1) мережі 1-way Long Short-Term Memory (LSTM), які є варіантом рекурентної нейронної мережі (RNN), яка здатна вивчати залежність порядку в послідовних даних32; і 2) двонаправлений стробований рекурентний блок (GRU), який є ще одним варіантом RNN.
Традиційними моделями, які використовувалися як базові лінії, були: 1) Випадковий ліс (RF), ансамблевий метод для класифікації та регресії; під час навчання він створює кілька дерев рішень;30 RF часто досягає найсучаснішої продуктивності в існуючій літературі щодо передбачень з використанням медичних даних. 2) Багатошаровий персептрон (MLP), проста модель нейронної мережі, яка не враховує тимчасову інформацію.
MLP складається з кількох рівнів персептрона, виконує зворотне навчання та використовує нелінійну функцію активації.31 3) Логістична регресія (LR), інтерпретована модель, яка часто використовується в існуючій літературі про прогнози реадмісії та застосовується до медичних даних; 4) AdaBoost, який менш схильний до переобладнання, оскільки його вхідні параметри не оптимізовані спільно.

Моделі DL були реалізовані за допомогою бібліотек Python «Keras», високорівневого API «TensorFlow». Бібліотека "Scikit-learn" була використана для реалізації традиційних моделей на Python.
Архітектура запропонованої моделі, LSTM, містить 128 нейронів, послідовний шар, шар зміни форми, який використовувався для зміни форми вхідних даних у 3-вимірний тензор, і шар маскування зі значенням маски 0 використовувався для пропуску часових кроків, для яких були відсутні дані.
Оскільки доповнення за допомогою 0 було виконано для уніфікації розмірів, шар маскування використовувався, щоб уникнути будь-яких обчислень із відсутніми значеннями в усіх шарах, наступних за шаром маскування, отже, відсутні значення не враховувалися під час навчання.
Крім того, між прихованими та вихідними шарами було додано пропуск. Використання цієї методики для випадкового вибору заданого відсотка для зменшення є поширеною технікою регулярізації, яка допомагає моделі вивчати загальні закономірності в даних.
RNN — це різновид нейронних мереж, які складаються з прихованих нейронів, які здатні аналізувати часові дані EHR.32 RNN має ту саму структуру, що й базова нейронна мережа, але нейрони на тому самому рівні з’єднані, що дозволяє нейрону навчатися з того самого сусідніх шарів, на додаток до навчання на виходах попередніх шарів і вхідних даних. Таким чином, нейрони RNN включають два джерела вхідних даних, теперішнє та недавнє минуле. Процес навчання визначається як:

Щоб обчислити значення �" прихованого нейрона �, функція нелінійного перетворення ReLU застосовується до зваженого �значення його лівого прихованого нейрона �"#$ і зваженого � значення його вхідного �.
Прогнози обчислюються за допомогою асигмоїдної функції зваженої � суми всіх прихованих нейронів із доданим зміщенням �. Недоліком RNN є те, що він страждає від проблеми зникнення градієнта, тобто ваги залишаються незмінними, що ускладнює конвергенцію моделі, отже, моделі важко навчатися.
Щоб вирішити цю проблему, було введено шар LSTM, у якому сигмоїдні нейрони RNN замінені більш складною структурою короткочасної пам’яті. LSTM має однакові ваги для всіх рівнів, що зменшує кількість параметрів, які обчислює мережа.

GRU є альтернативним рішенням для проблеми зникнення градієнта. Він замінює простий нейрон на закритий блок, який має менше параметрів, ніж нейрони LSTM, оскільки йому не вистачає вихідного вентиля.33
For more information:1950477648nn@gmail.com